Содержание:
Простейший мониторинг раз в минуту открывает главную страницу и сообщает, если она недоступна. Это лучше, чем узнать о сбое от клиента, но для коммерческого сайта недостаточно. Главная может отвечать кодом 200, пока форма не отправляет заявки, корзина не оформляет заказ, база перегружена, а обмен с 1С остановлен.
Рабочая система мониторинга строится слоями: внешняя доступность, ключевые бизнес-сценарии, ошибки приложения, ресурсы инфраструктуры и состояние интеграций. Для каждого сигнала заранее определяют порог, получателя и действие.
Что именно должен обнаруживать мониторинг
| Уровень | Что проверяем | Какую проблему обнаруживаем |
|---|---|---|
| DNS и SSL | Разрешение домена, срок сертификата, TLS | Ошибка делегирования или просроченный сертификат |
| HTTP-доступность | Код, время ответа, нужный фрагмент страницы | Полный отказ, заглушку, ошибочный редирект |
| Бизнес-функция | Форму, корзину, авторизацию, API | Сайт открыт, но не выполняет целевое действие |
| Приложение | Ошибки, исключения, фоновые задания | Сбой кода, очереди или конкретной функции |
| Инфраструктура | CPU, память, диск, процессы, база | Исчерпание ресурса до полного отказа |
| Интеграции | CRM, 1С, платежи, почту, внешние API | Задержку или накопление необработанных данных |
Не каждый проект требует всех уровней сразу. Для визитки достаточно внешней проверки, SSL и формы. Для магазина добавляют тест заказа, платежный статус, очередь писем, базу и ресурсы. Для B2B-портала мониторят обмены, документы и персонализированные функции.
Внешняя проверка доступности
Монитор должен находиться вне той же инфраструктуры, иначе общий сбой может отключить и сайт, и проверяющую систему. Он обращается к HTTPS-адресу, контролирует код ответа, время и содержимое.
Одного запроса из одного города недостаточно для диагностики региональной проблемы. Если проект работает по всей России, полезны проверки из нескольких точек или повторное подтверждение с другой сети. При этом каждое краткое сетевое колебание не должно будить команду.
| Параметр | Стартовая настройка | Зачем |
|---|---|---|
| Интервал | 1–5 минут по критичности | Определяет максимальную задержку обнаружения |
| Тайм-аут | Выше нормального ответа, но ниже бизнес-критичного ожидания | Отделяет замедление от полного зависания |
| Подтверждение | 2–3 неудачи или вторая точка | Снижает ложные тревоги |
| Контентная проверка | Ожидаемый текст или элемент | Не принимает страницу ошибки с кодом 200 за норму |
| Срок SSL | Предупреждение заранее | Оставляет время исправить выпуск сертификата |
Частоту выбирают через стоимость простоя. Проверка раз в пять минут может быть нормальной для информационного сайта, но слишком редкой для магазина с постоянными заказами.
Проверка ключевых бизнес-сценариев
Синтетический монитор повторяет безопасное действие пользователя: открывает карточку, добавляет тестовый товар, доходит до шага оформления или отправляет специальную техническую форму. Он не должен создавать реальные сделки и списания.
Для формы можно использовать отдельный адрес и метку, а затем проверять появление события в CRM. Для магазина — тестовый товар и платёжный режим провайдера. Для B2B-системы — технического пользователя с ограниченными правами.
Сценарий должен быть коротким и устойчивым. Если он зависит от десятка внешних сервисов, сигнал будет шумным. Сложную цепочку лучше разделить на этапы, чтобы тревога показывала место остановки.
Ошибки приложения и фоновые процессы
Система собирает исключения приложения с URL, версией релиза и техническим контекстом без лишних персональных данных. Важно видеть не только количество ошибок, но и появление нового типа после обновления.
Отдельно контролируют cron, очереди, импорт, формирование документов и отправку писем. Простая проверка «процесс запущен» недостаточна: очередь может работать, но отставать на несколько часов.
| Сигнал | Что считать тревогой | Пример реакции |
|---|---|---|
| Ошибки приложения | Резкий рост или новая критичная ошибка | Назначить разработчику, сопоставить с релизом |
| Очередь | Растёт возраст старейшей задачи | Проверить обработчики и внешний сервис |
| Cron | Нет успешного запуска в ожидаемом окне | Проверить планировщик и журнал задания |
| Импорт | Не завершён вовремя или объём резко изменился | Остановить повторные запуски, проверить пакет |
| Почта | Растут отказы или нет контрольного письма | Проверить очередь, домен и провайдера |
Ресурсы сервера и базы
Мониторят CPU, память, swap, свободный диск, I/O, число процессов, соединения базы и время запросов. Порог должен учитывать длительность: краткий пик CPU во время импорта нормален, постоянная очередь запросов — нет.
Полезно наблюдать четыре группы сигналов: задержку, объём трафика или операций, ошибки и насыщение ресурсов. Такой подход соответствует «золотым сигналам» мониторинга, описанным в книге Google SRE. Для конкретного сайта они переводятся в понятные метрики: время ответа, число заказов, доля ошибок и запас CPU, памяти или соединений.
Как настроить оповещения без постоянного шума
Если система отправляет десятки сообщений без действия, их начинают игнорировать. Каждая тревога должна отвечать на три вопроса: что произошло, насколько это критично и кто сейчас обязан отреагировать.
| Уровень | Пример | Канал и реакция |
|---|---|---|
| Критический | Сайт недоступен, заказы не создаются, подозрение на утечку | Звонок или дежурный канал, немедленная реакция |
| Высокий | Резкий рост ошибок, очередь отстаёт, диск почти заполнен | Мессенджер и задача ответственному в течение SLA |
| Средний | Замедление, редкие ошибки отдельной функции | Задача на рабочее время и наблюдение |
| Информационный | Смена версии, завершение копии, восстановление сигнала | Журнал или ежедневный отчёт |
Оповещение после восстановления не менее важно, чем сообщение о сбое. Оно закрывает инцидент только после контрольной проверки, а не после одного успешного запроса.
Кому и когда отправлять тревогу
Для каждого сервиса назначают владельца со стороны бизнеса и технического ответственного. Ночной сигнал имеет смысл только тогда, когда есть человек с доступом, полномочиями и регламентом. Иначе круглосуточный мониторинг просто фиксирует простой до утра.
Небольшому корпоративному сайту часто достаточно уведомления ответственному менеджеру и подрядчику в рабочее время, кроме полного отказа. Для магазина или B2B-портала маршрутизация зависит от стоимости простоя и SLA.
Практические сценарии для бизнеса
| Проект | Минимальный набор | Что добавить по мере роста |
|---|---|---|
| Корпоративный сайт | Главная, форма, SSL, срок домена | CRM, почту, ошибки приложения |
| Интернет-магазин | Категория, корзина, тестовый заказ, база, ресурсы | Платежи, остатки, очереди, несколько регионов |
| B2B-портал | Авторизация, ключевая операция, API, обмен | SLA по интеграциям, аудит действий, резервный контур |
| Сайт с рекламой | Целевые страницы, формы, аналитика | Автопауза кампаний по подтверждённому сбою |
Автоматическую остановку рекламы следует внедрять осторожно: ложный сигнал не должен отключать кампанию на весь день. Нужны подтверждение из второй точки, журнал решения и уведомление специалисту по рекламе.
Мониторинг реальных пользователей и синтетические тесты
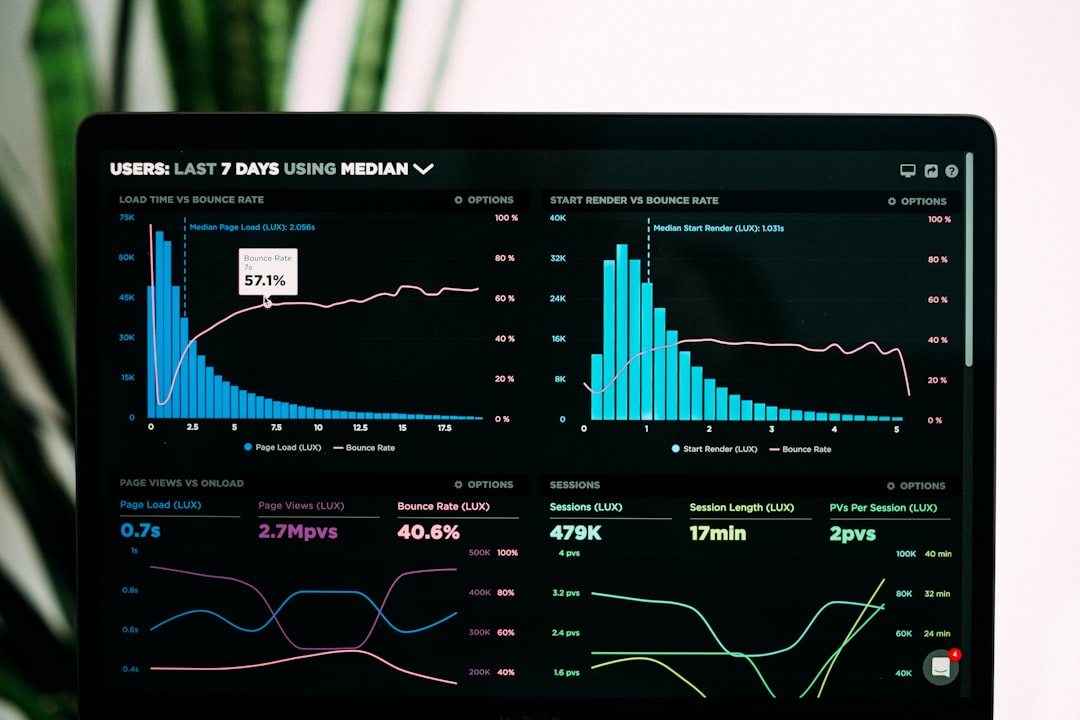
Синтетические проверки выполняются регулярно и позволяют заметить отказ даже ночью без посетителей. Данные реальных пользователей показывают, как сайт работает на их устройствах и сетях. Они дополняют друг друга.
Лабораторный тест скорости полезен для диагностики, но не заменяет мониторинг доступности. Аналогично код 200 не доказывает, что страница быстро открылась и пользователь смог отправить форму.
Отчёты и проверка эффективности
Еженедельный или ежемесячный отчёт должен показывать доступность, количество и длительность инцидентов, время обнаружения, время реакции, повторяющиеся ошибки и выполнение бизнес-сценариев. Большая панель с сотней графиков без решений пользы не даёт.
После каждого существенного инцидента корректируют пороги и регламент. Если монитор не заметил остановку обмена, добавляют проверку возраста последней успешной операции. Если сигнал оказался ложным, уточняют условие подтверждения.
Порядок внедрения мониторинга
Шаг 1. Выбрать 3–5 функций, потеря которых прямо влияет на заявки, продажи или договорные обязательства.
Шаг 2. Настроить внешнюю доступность и SSL.
Шаг 3. Подключить ошибки приложения и ресурсы.
Шаг 4. Добавить бизнес-сценарии и интеграции.
Шаг 5. Провести учебную тревогу и проверить, кто реально реагирует.
Такую работу удобно начинать с небольшого договора: схема проекта, список сигналов, настройка базовых проверок и тестовое оповещение. Затем состав расширяется по фактическим инцидентам.
Частые вопросы
Как часто проверять доступность сайта?
Обычно раз в 1–5 минут в зависимости от стоимости простоя. Критичный сервис проверяют чаще, но обязательно используют подтверждение, чтобы снизить число ложных тревог.
Достаточно ли контролировать код 200?
Нет. Сервер может отдавать заглушку или пустую страницу с кодом 200. Нужно проверять ожидаемое содержимое и хотя бы одну ключевую бизнес-функцию.
Можно ли мониторить отправку формы?
Да. Используют специальный тестовый сценарий и метку, а затем проверяют получение события. Тестовые обращения не должны смешиваться с реальными лидами.
Нужен ли мониторинг 24/7, если поддержка работает днём?
Он всё равно фиксирует точное начало и длительность сбоя. Но ночное оповещение должно иметь адресата и действие; иначе достаточно отчёта к началу рабочего дня.
Что важнее: мониторинг сайта или сервера?
Нужны оба уровня. Сервер может быть доступен, пока приложение не работает, а внешняя ошибка не всегда показывает, какой ресурс закончился.
Как избежать ложных срабатываний?
Использовать несколько последовательных проверок, вторую точку, разумные тайм-ауты, окна обслуживания и разные пороги для предупреждения и аварии.
Нужно настроить мониторинг и регламент реакции?
German Web может определить критичные функции, подключить внешние и серверные проверки, настроить оповещения и провести тестовый инцидент. Первый этап можно ограничить небольшим согласованным набором работ. Ставка разработчика — 2 300 ₽ в час; подробнее — в разделе технической поддержки сайтов.